

AGI (কৃত্রিম সাধারণ বুদ্ধিমত্তা) হল সমগ্র AI শিল্পের পবিত্র কন্ঠ।
প্রাক্তন OpenAI প্রধান বিজ্ঞানী ইলিয়া সুটস্কেভ গত বছর একটি মতামত প্রকাশ করেছেন: "যতদিন আমরা পরবর্তী টোকেনটি খুব ভালভাবে ভবিষ্যদ্বাণী করতে পারি, আমরা মানুষকে AGI অর্জনে সহায়তা করতে পারি।"
টুরিং পুরস্কার বিজয়ী জিওফ্রে হিন্টন, যিনি গভীর শিক্ষার জনক হিসেবে পরিচিত, এবং OpenAI সিইও স্যাম অল্টম্যান উভয়েই বিশ্বাস করেন যে AGI দশ বছরের মধ্যে বা তারও আগে আসবে৷
এজিআই শেষ নয়, মানব উন্নয়নের ইতিহাসে একটি নতুন সূচনা বিন্দু। এজিআই-এর পথে বিবেচনা করার মতো অনেক বিষয় রয়েছে এবং চীনের এআই শিল্পও এমন একটি শক্তি যা উপেক্ষা করা যায় না।
27 এপ্রিল অনুষ্ঠিত Zhongguancun ফোরাম জেনারেল কৃত্রিম বুদ্ধিমত্তা সমান্তরাল ফোরামে, Sophon Engine, চীনের রেনমিন বিশ্ববিদ্যালয়ের সাথে সংযুক্ত একটি স্টার্টআপ কোম্পানি, AGI-এর দিকে একটি গুরুত্বপূর্ণ পদক্ষেপ গ্রহণ করে একটি নতুন মাল্টি-মডেল বড় মডেল Awaker 1.0 প্রকাশ করেছে।
Sophon ইঞ্জিনের পূর্ববর্তী প্রজন্মের ChatImg সিকোয়েন্স মডেলের সাথে তুলনা করে, Awaker 1.0 একটি নতুন MOE আর্কিটেকচার গ্রহণ করে এবং এটি স্বাধীন আপডেট করার ক্ষমতা রাখে। ভিজ্যুয়াল জেনারেশনের পরিপ্রেক্ষিতে, Awaker 1.0 একটি সম্পূর্ণ স্ব-উন্নত ভিডিও জেনারেশন বেস ভিডিটি ব্যবহার করে, যা ফটো ভিডিও জেনারেশনে সোরার থেকে ভালো ফলাফল অর্জন করে, বড় মডেলের অবতরণের "শেষ মাইল" অসুবিধাকে ভেঙে দেয়।
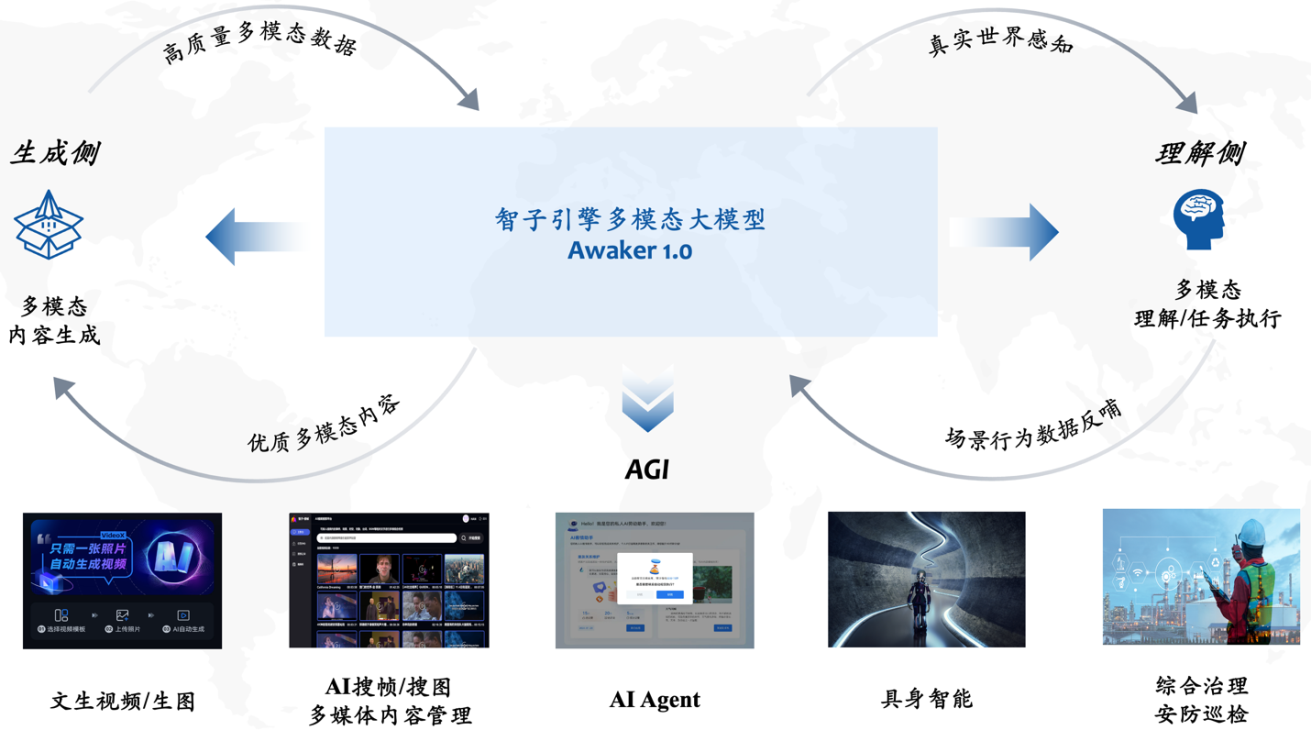
Awaker এর MOE বেস মডেল
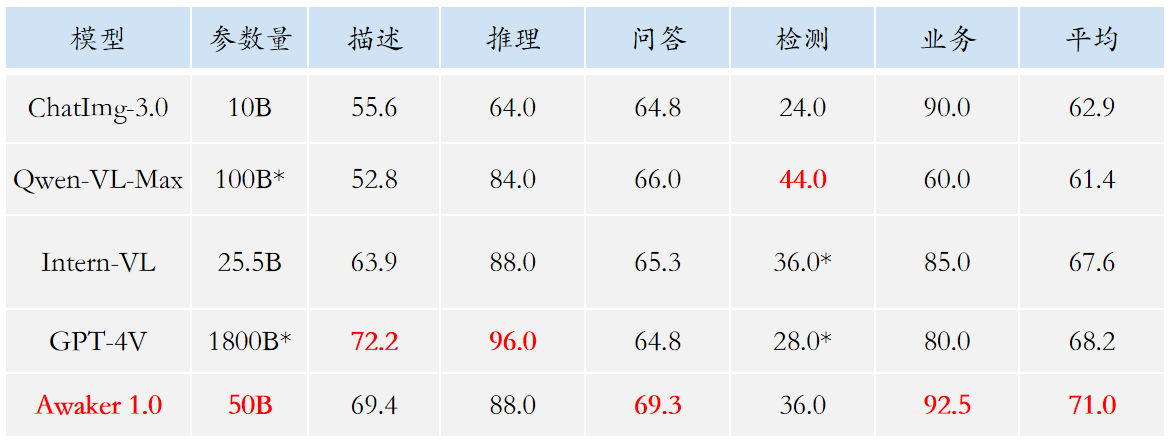
বোঝার দিক থেকে, Awaker 1.0 এর বেস মডেলটি প্রধানত মাল্টি-মডেল এবং মাল্টি-টাস্ক প্রাক-প্রশিক্ষণের গুরুতর দ্বন্দ্বের সমস্যা সমাধান করে। যত্ন সহকারে ডিজাইন করা মাল্টি-টাস্ক MOE আর্কিটেকচার থেকে উপকৃত হয়ে, Awaker 1.0-এর বেস মডেলটি শুধুমাত্র Sophon Engine-এর আগের প্রজন্মের মাল্টি-মডেল বড় মডেল ChatImg-এর মৌলিক ক্ষমতার উত্তরাধিকারী হতে পারে না, বরং প্রতিটি মাল্টি-মডেল টাস্কের জন্য প্রয়োজনীয় অনন্য ক্ষমতাগুলিও শিখতে পারে। . পূর্ববর্তী প্রজন্মের মাল্টি-মডেল বড় মডেল ChatImg-এর সাথে তুলনা করে, Awaker 1.0-এর বেস মডেল ক্ষমতা একাধিক কাজে ব্যাপকভাবে উন্নত করা হয়েছে।
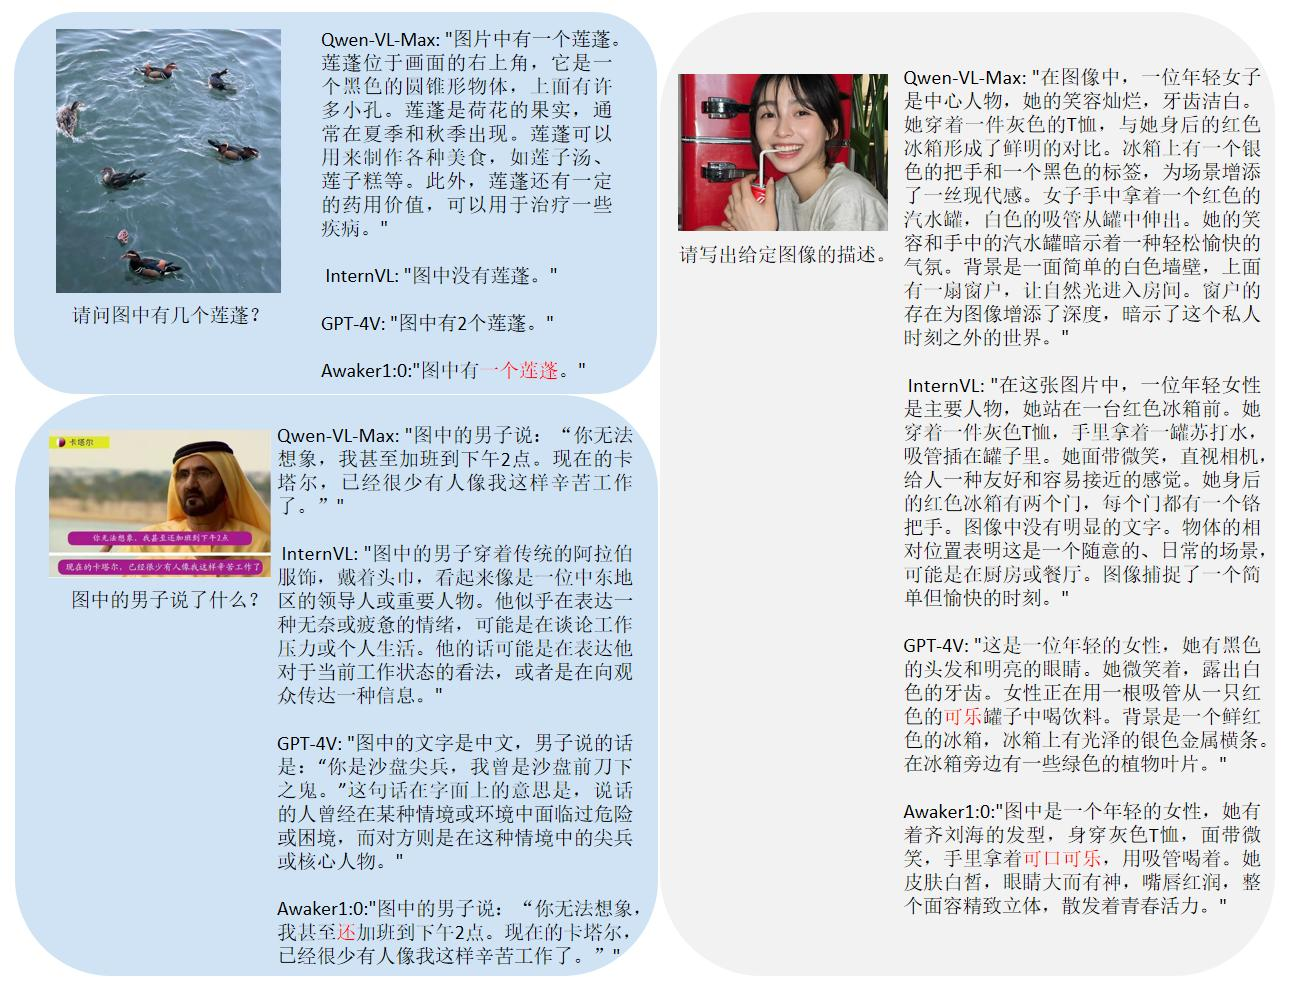
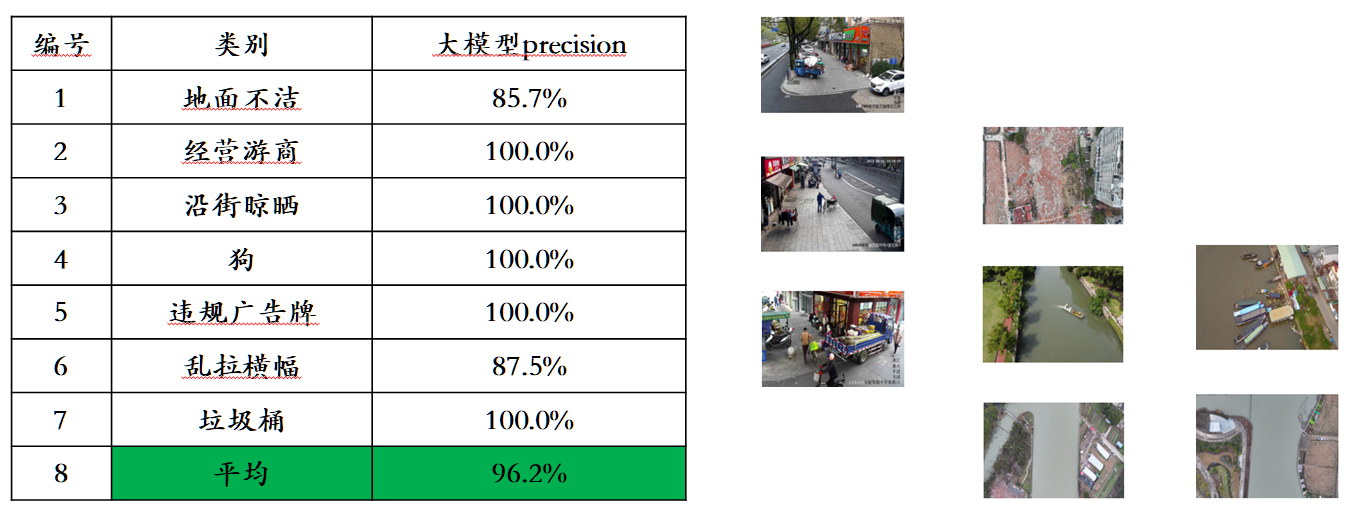
মূলধারার মাল্টি-মোডাল মূল্যায়ন তালিকায় মূল্যায়ন ডেটা ফাঁসের সমস্যার পরিপ্রেক্ষিতে, সোফোন ইঞ্জিন তার নিজস্ব মূল্যায়ন সেট তৈরি করার জন্য একটি কঠোর মান প্রকাশ করেছে, যেখানে বেশিরভাগ পরীক্ষার ছবি ব্যক্তিগত মোবাইল ফোন অ্যালবাম থেকে আসে। এই মাল্টি-মডেল মূল্যায়ন সেটে, এটি Awaker 1.0 এবং দেশে এবং বিদেশে তিনটি সবচেয়ে উন্নত মাল্টি-মডেল বৃহৎ মডেলে ন্যায্য ম্যানুয়াল মূল্যায়ন পরিচালনা করে যার বিস্তারিত মূল্যায়ন ফলাফল নীচের সারণীতে দেখানো হয়েছে। নোট করুন যে জিপিটি-4ভি এবং ইন্টার্ন-ভিএল সনাক্তকরণের কাজগুলিকে সরাসরি সমর্থন করে না তাদের সনাক্তকরণের ফলাফলগুলি বস্তুর অভিযোজন বর্ণনা করার জন্য ভাষা ব্যবহার করার মাধ্যমে প্রাপ্ত করা হয়।
জাগ্রত + মূর্ত বুদ্ধিমত্তা: এজিআইয়ের দিকে
মাল্টি-মডেল বড় মডেল এবং মূর্ত বুদ্ধিমত্তার সংমিশ্রণ খুবই স্বাভাবিক, কারণ মাল্টি-মডেল বড় মডেলের চাক্ষুষ বোঝার ক্ষমতা স্বাভাবিকভাবেই মূর্ত বুদ্ধিমান ক্যামেরার সাথে মিলিত হতে পারে। কৃত্রিম বুদ্ধিমত্তার ক্ষেত্রে, "মাল্টি-মডেল বড় মডেল + মূর্ত বুদ্ধিমত্তা" এমনকি সাধারণ কৃত্রিম বুদ্ধিমত্তা (এজিআই) অর্জনের জন্য একটি সম্ভাব্য পথ হিসাবে বিবেচিত হয়।
একদিকে, লোকেরা মূর্ত বুদ্ধিকে অভিযোজনযোগ্য বলে আশা করে, অর্থাৎ, এজেন্ট ক্রমাগত শিক্ষার মাধ্যমে পরিবর্তনশীল অ্যাপ্লিকেশন পরিবেশের সাথে খাপ খাইয়ে নিতে পারে এটি কেবল পরিচিত বহু-মডেল কাজগুলিতে আরও ভাল করতে পারে না, তবে অজানা মাল্টির সাথে দ্রুত খাপ খাইয়ে নিতে পারে – মডেল কাজ। অন্যদিকে, মানুষও আশা করে যে মূর্ত বুদ্ধি সত্যিকারের সৃজনশীল হবে, এই আশায় যে এটি নতুন কৌশল এবং সমাধান আবিষ্কার করতে পারে এবং পরিবেশের স্বায়ত্তশাসিত অন্বেষণের মাধ্যমে কৃত্রিম বুদ্ধিমত্তার ক্ষমতার সীমানা অন্বেষণ করতে পারে। মূর্ত বুদ্ধিমত্তার "মস্তিষ্ক" হিসাবে বৃহৎ মাল্টি-মডেল মডেলগুলি ব্যবহার করে, মূর্ত বুদ্ধিমত্তার অভিযোজনযোগ্যতা এবং সৃজনশীলতাকে ব্যাপকভাবে উন্নত করা সম্ভব, যার ফলে শেষ পর্যন্ত AGI (বা এমনকি AGI অর্জন) এর দ্বারপ্রান্তে পৌঁছে যায়।
যাইহোক, বিদ্যমান বৃহৎ মাল্টি-মডেল মডেলগুলির সাথে দুটি সুস্পষ্ট সমস্যা রয়েছে: প্রথমত, মডেলের পুনরাবৃত্তিমূলক আপডেট চক্রটি দীর্ঘ, যার জন্য প্রচুর মানবিক এবং আর্থিক বিনিয়োগের প্রয়োজন হয়, দ্বিতীয়ত, মডেলের প্রশিক্ষণ ডেটা সমস্ত বিদ্যমান ডেটা থেকে নেওয়া হয়; , এবং মডেল ক্রমাগত নতুন জ্ঞান বিপুল পরিমাণ অর্জন করতে অক্ষম. যদিও ক্রমাগত নতুন জ্ঞান এছাড়াও RAG এবং দীর্ঘ প্রেক্ষাপটের মাধ্যমে ইনজেকশন করা যেতে পারে, মাল্টি-মডেল বড় মডেল নিজেই এই নতুন জ্ঞান শিখতে পারে না, এবং এই দুটি প্রতিকার পদ্ধতি অতিরিক্ত সমস্যা নিয়ে আসবে। সংক্ষেপে, বর্তমান বৃহৎ মাল্টি-মোডাল মডেলগুলি বাস্তব প্রয়োগের পরিস্থিতিতে খুব বেশি মানিয়ে নিতে পারে না, সৃজনশীলকে ছেড়ে দিন, যার ফলে শিল্পে প্রয়োগ করার সময় বিভিন্ন অসুবিধা হয়।
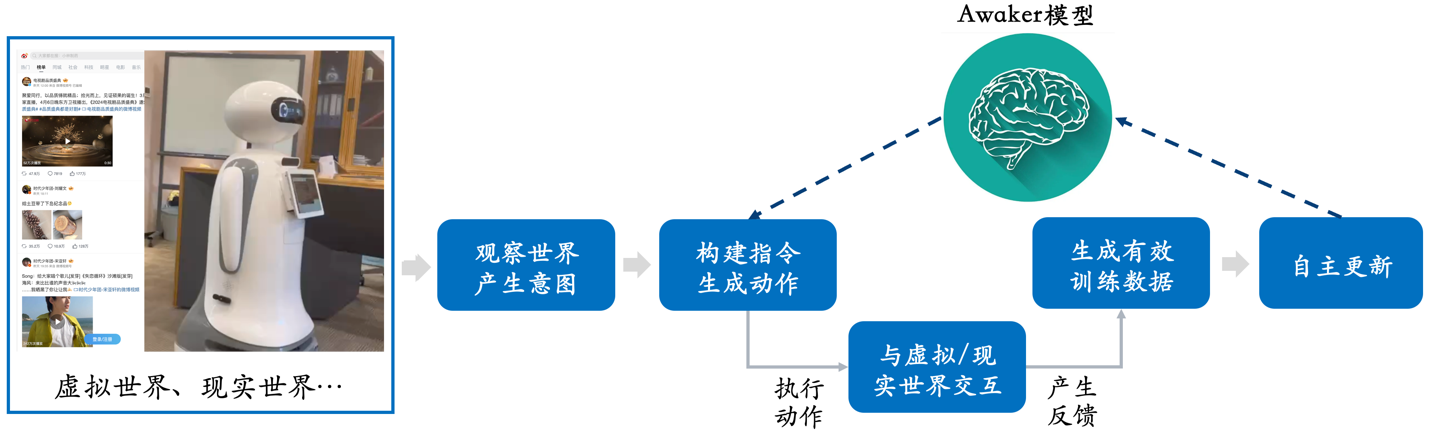
Sophon Engine দ্বারা প্রকাশিত Awaker 1.0 হল বিশ্বের প্রথম মাল্টি-মডেল বড় মডেল যার একটি স্বায়ত্তশাসিত আপডেট ব্যবস্থা রয়েছে, যা মূর্ত বুদ্ধিমত্তার "মস্তিষ্ক" হিসাবে ব্যবহার করা যেতে পারে। Awaker 1.0-এর স্বায়ত্তশাসিত আপডেট পদ্ধতিতে তিনটি মূল প্রযুক্তি রয়েছে: সক্রিয় ডেটা জেনারেশন, মডেল প্রতিফলন এবং মূল্যায়ন, এবং ক্রমাগত মডেল আপডেট।
অন্যান্য সমস্ত বড় মাল্টি-মোডাল মডেল থেকে আলাদা, Awaker 1.0 হল "লাইভ" এবং এর পরামিতিগুলি রিয়েল টাইমে ক্রমাগত আপডেট করা যেতে পারে। উপরের ফ্রেম চিত্র থেকে দেখা যায়, Awaker 1.0 বিভিন্ন স্মার্ট ডিভাইসের সাথে একত্রিত হতে পারে, স্মার্ট ডিভাইসের মাধ্যমে বিশ্বকে পর্যবেক্ষণ করতে পারে, অ্যাকশনের উদ্দেশ্য তৈরি করতে পারে এবং বিভিন্ন অ্যাকশন সম্পূর্ণ করার জন্য স্মার্ট ডিভাইসগুলিকে নিয়ন্ত্রণ করার জন্য স্বয়ংক্রিয়ভাবে নির্দেশনা তৈরি করতে পারে। স্মার্ট ডিভাইসগুলি স্বয়ংক্রিয়ভাবে বিভিন্ন ক্রিয়া সম্পন্ন করার পরে বিভিন্ন প্রতিক্রিয়া তৈরি করবে এবং ক্রমাগত স্ব-আপডেট করার জন্য এই অ্যাকশনগুলি এবং প্রতিক্রিয়াগুলি থেকে কার্যকর প্রশিক্ষণ ডেটা পেতে পারে এবং মডেলের বিভিন্ন ক্ষমতাকে ক্রমাগত শক্তিশালী করতে পারে৷
একটি উদাহরণ হিসাবে নতুন জ্ঞান ইনজেকশন গ্রহণ, Awaker 1.0 ক্রমাগত ইন্টারনেটে সর্বশেষ সংবাদ তথ্য শিখতে পারে এবং নতুন শেখা সংবাদ তথ্যের উপর ভিত্তি করে বিভিন্ন জটিল প্রশ্নের উত্তর দিতে পারে। RAG এবং দীর্ঘ প্রেক্ষাপটের ঐতিহ্যগত পদ্ধতি থেকে ভিন্ন, Awaker 1.0 সত্যিকার অর্থে নতুন জ্ঞান শিখতে পারে এবং মডেলের পরামিতিগুলিতে এটি "মুখস্থ" করতে পারে।
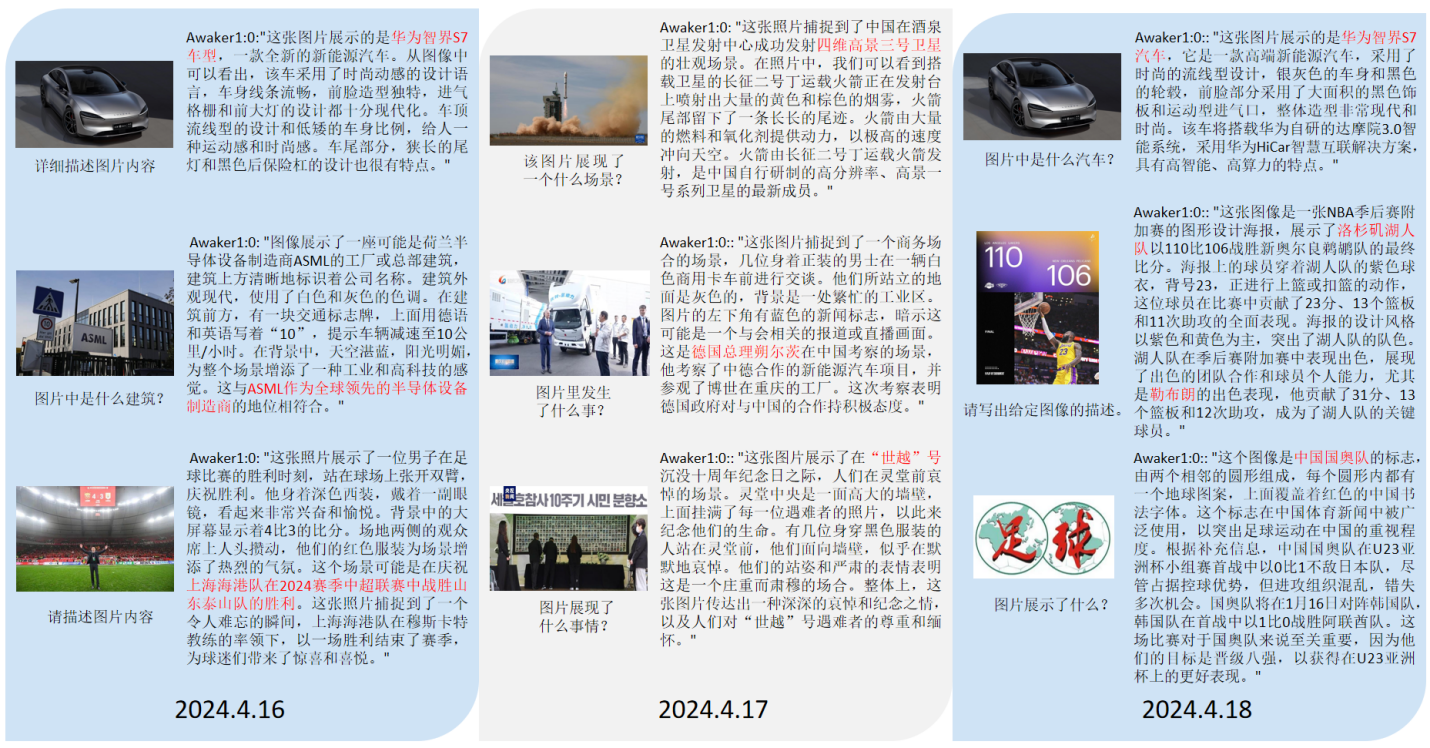
উপরের উদাহরণ থেকে দেখা যায়, টানা তিনদিন স্ব-আপডেট করার সময়, Awaker 1.0 প্রতিদিনের খবরের তথ্য জানতে সক্ষম হয়েছিল এবং প্রশ্নের উত্তর দেওয়ার সময় সঠিকভাবে সংশ্লিষ্ট তথ্য বলতে সক্ষম হয়েছিল। একই সময়ে, Awaker 1.0 অবিচ্ছিন্ন শেখার প্রক্রিয়া চলাকালীন শেখা জ্ঞান ভুলে যাবে না, উদাহরণস্বরূপ, Zhijie S7 এর জ্ঞান 2 দিন পরেও Awaker 1.0 দ্বারা মনে রাখা বা বোঝা যায়।
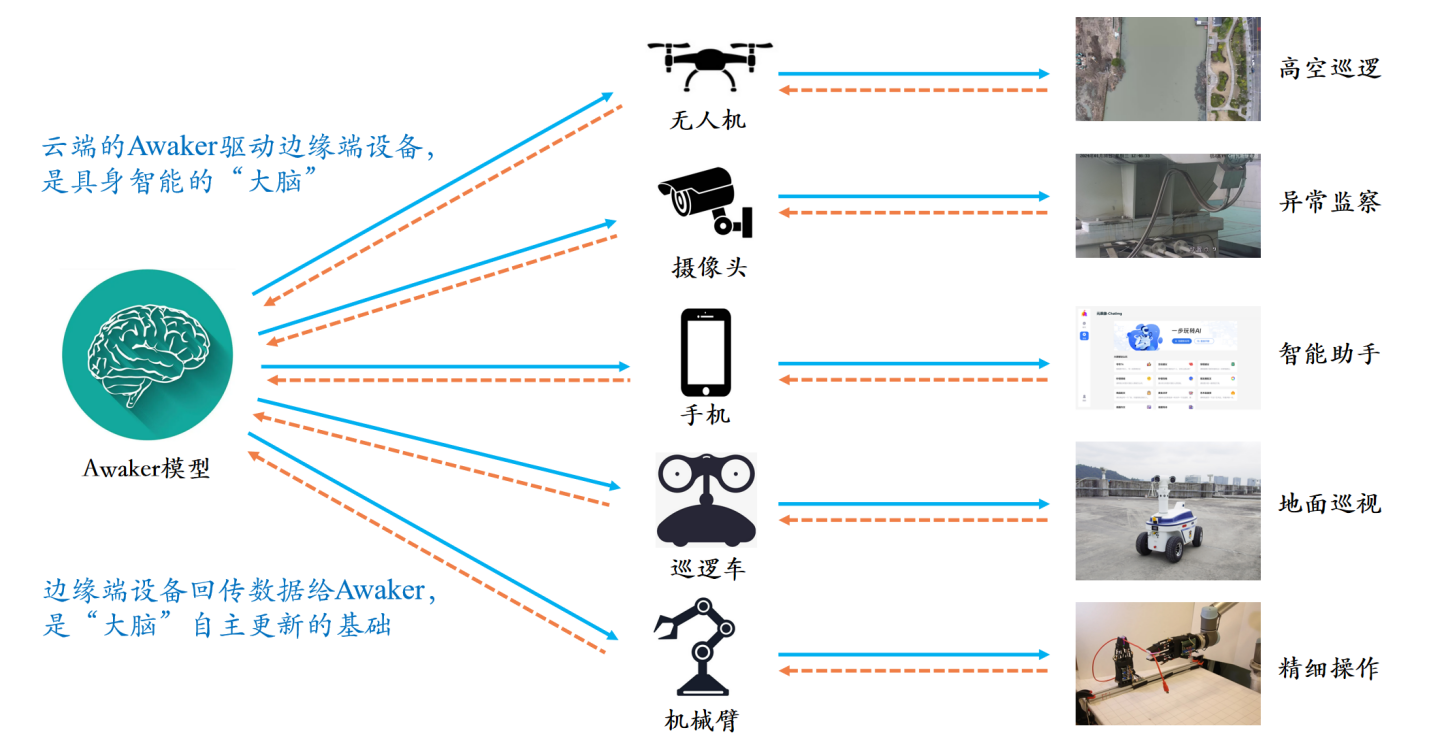
Awaker 1.0 এছাড়াও ক্লাউড-এজ সহযোগিতা অর্জনের জন্য বিভিন্ন স্মার্ট ডিভাইসের সাথে একত্রিত করা যেতে পারে। Awaker 1.0 বিভিন্ন কাজ সম্পাদনের জন্য বিভিন্ন প্রান্তের স্মার্ট ডিভাইসগুলিকে নিয়ন্ত্রণ করতে "মস্তিষ্ক" হিসাবে ক্লাউডে স্থাপন করা হয়। এজ স্মার্ট ডিভাইসটি বিভিন্ন কাজ সম্পাদন করার সময় প্রাপ্ত প্রতিক্রিয়া ক্রমাগতভাবে Awaker 1.0-এ ফেরত পাঠানো হবে, যা এটিকে ক্রমাগত প্রশিক্ষণের ডেটা প্রাপ্ত করতে এবং ক্রমাগত নিজেকে আপডেট করতে দেয়।
বাস্তব বিশ্বের সিমুলেটর: ভিডিটি
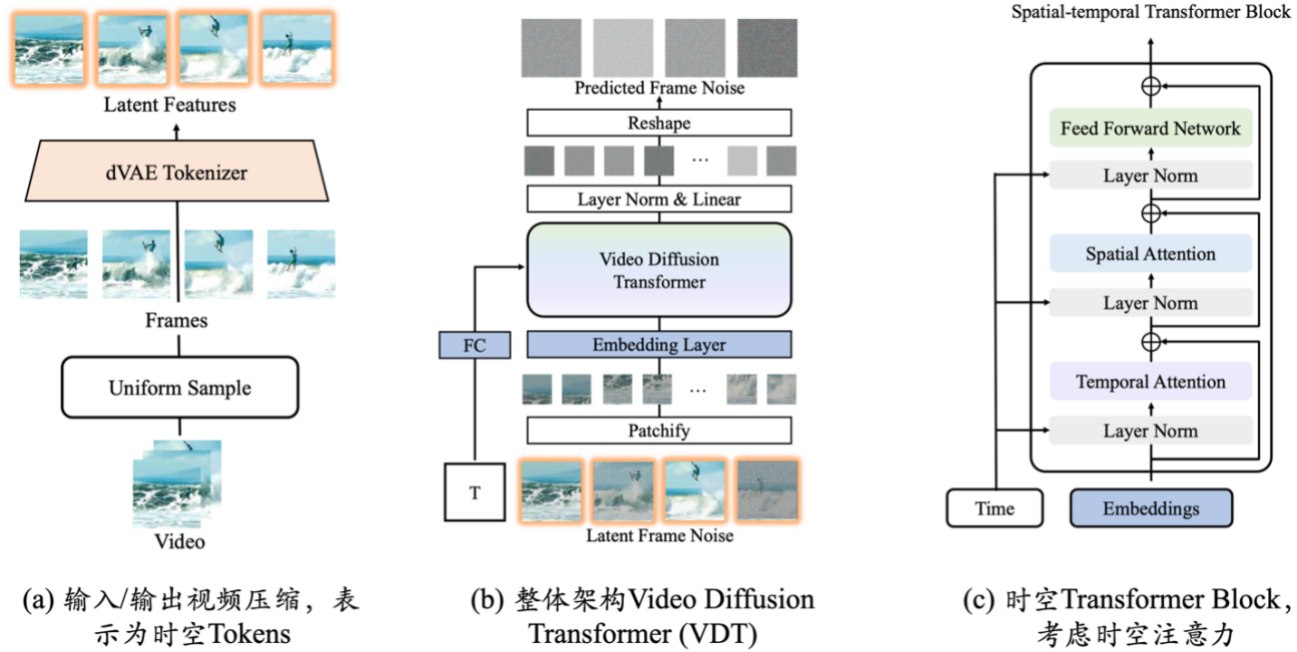
ভিডিও জেনারেশন বেস ভিডিটির উদ্ভাবনগুলির মধ্যে প্রধানত নিম্নলিখিত দিকগুলি অন্তর্ভুক্ত রয়েছে:
- ডিফিউশন-ভিত্তিক ভিডিও জেনারেশনে ট্রান্সফরমার প্রযুক্তি প্রয়োগ করা ভিডিও জেনারেশনের ক্ষেত্রে ট্রান্সফরমারের বিশাল সম্ভাবনা প্রদর্শন করে। VDT-এর সুবিধা হল এর চমৎকার সময়-নির্ভর ক্যাপচার ক্ষমতা, যা সময়ের সাথে সাথে ত্রিমাত্রিক বস্তুর শারীরিক গতিশীলতা অনুকরণ সহ অস্থায়ীভাবে সুসংগত ভিডিও ফ্রেম তৈরি করতে সক্ষম করে।
- এই প্রযুক্তির ব্যাপক প্রয়োগ উপলব্ধি করে ভিডিও তৈরির বিভিন্ন কাজ পরিচালনা করতে VDT সক্ষম করার জন্য একটি ইউনিফাইড স্প্যাটিওটেম্পোরাল মাস্ক মডেলিং প্রক্রিয়ার প্রস্তাব করা হয়েছে। VDT-এর নমনীয় শর্তসাপেক্ষ তথ্য প্রক্রিয়াকরণ পদ্ধতি, যেমন সরল টোকেন স্পেস স্প্লিসিং, কার্যকরভাবে বিভিন্ন দৈর্ঘ্য এবং পদ্ধতির তথ্য একত্রিত করে। একই সময়ে, স্প্যাটিওটেম্পোরাল মাস্ক মডেলিং মেকানিজমের সাথে একত্রিত হয়ে, ভিডিটি একটি সার্বজনীন ভিডিও ডিফিউশন টুল হয়ে উঠেছে, যা শর্তহীন জেনারেশন, ভিডিও পরবর্তী ফ্রেমের পূর্বাভাস, ফ্রেম ইন্টারপোলেশন, ছবি তৈরি করা ভিডিও এবং ভিডিও ফ্রেমে পরিবর্তন না করেই প্রয়োগ করা যেতে পারে। মডেল গঠন এবং অন্যান্য ভিডিও প্রজন্মের কাজ।
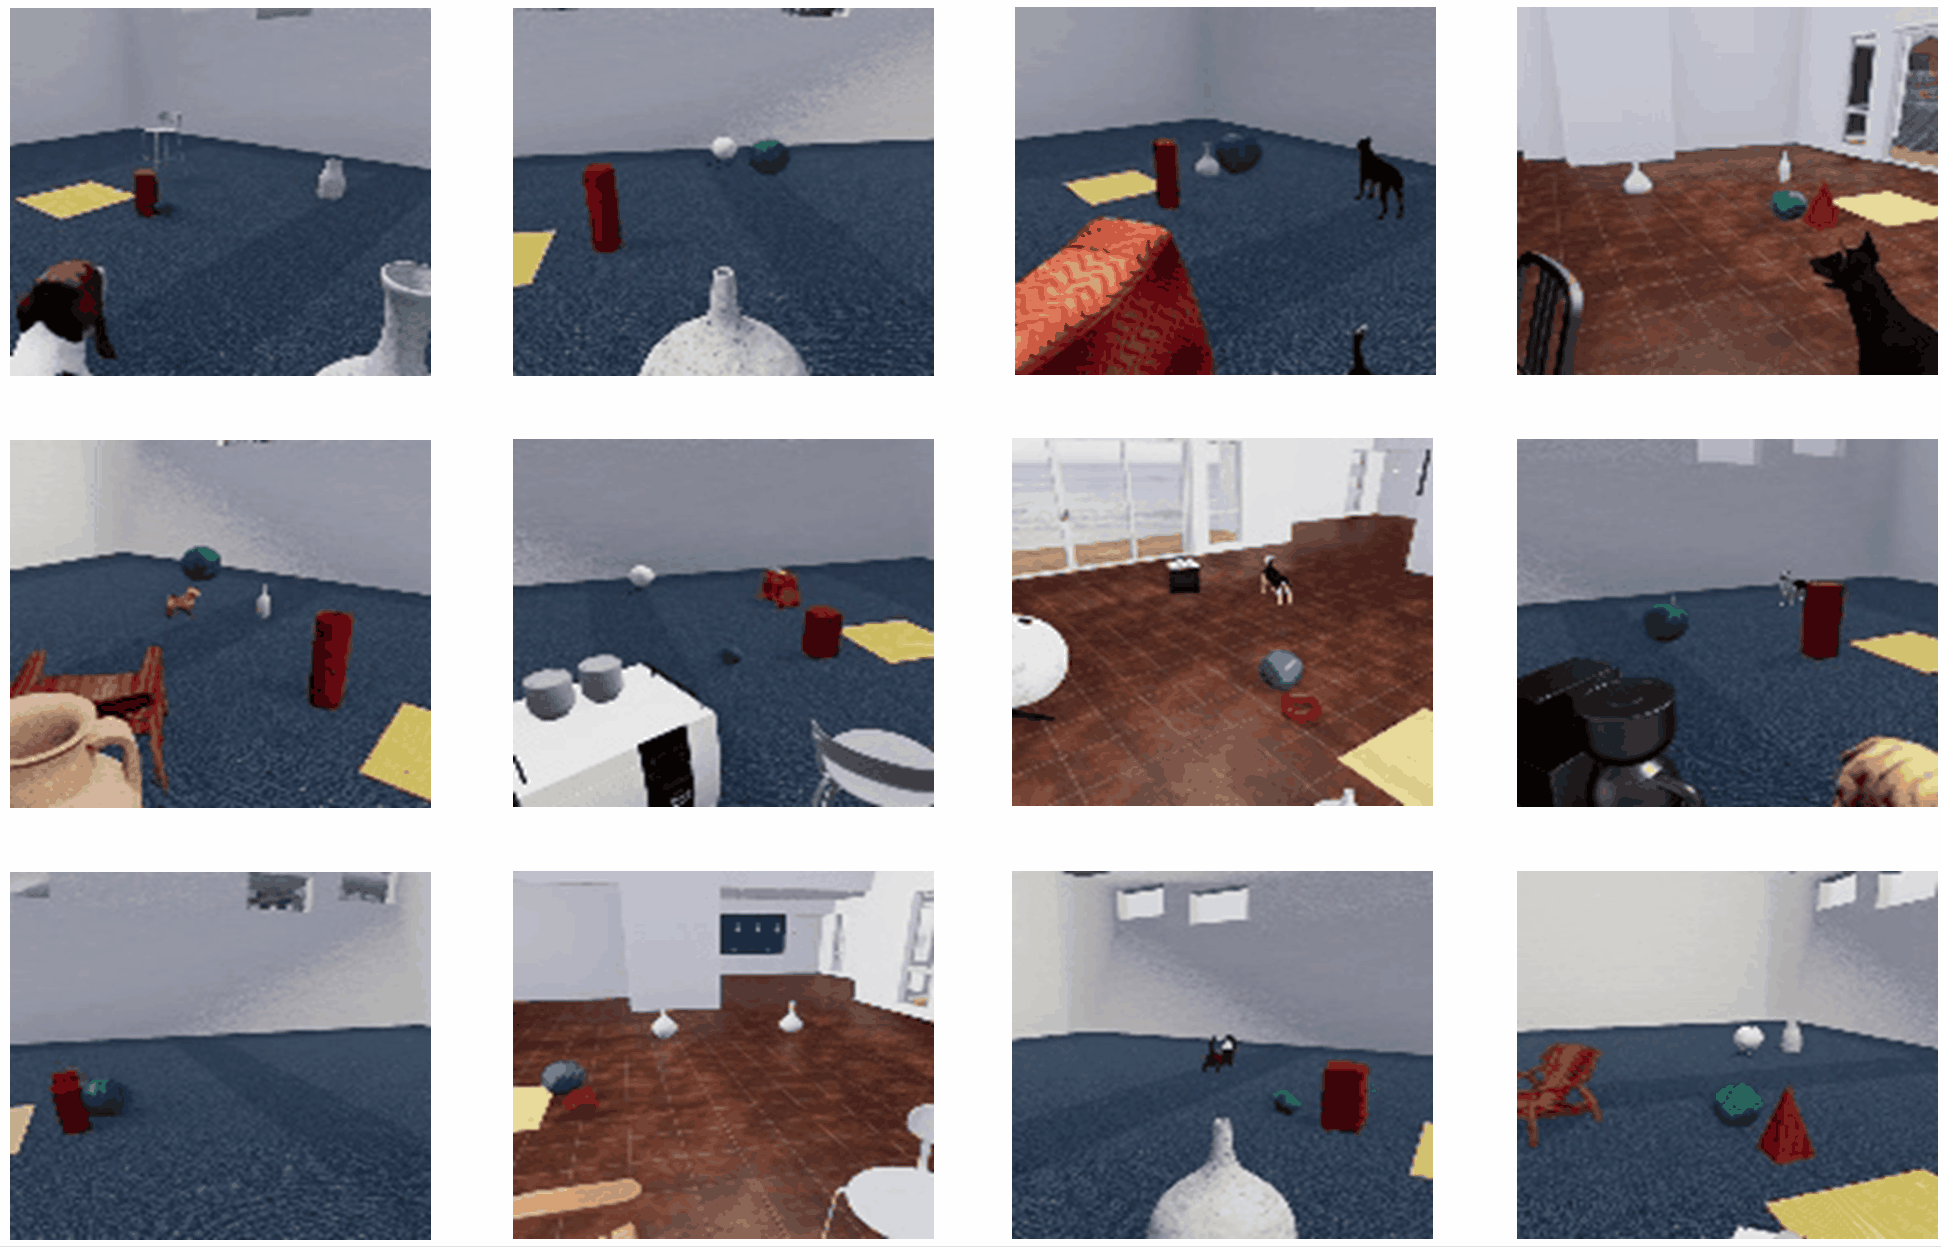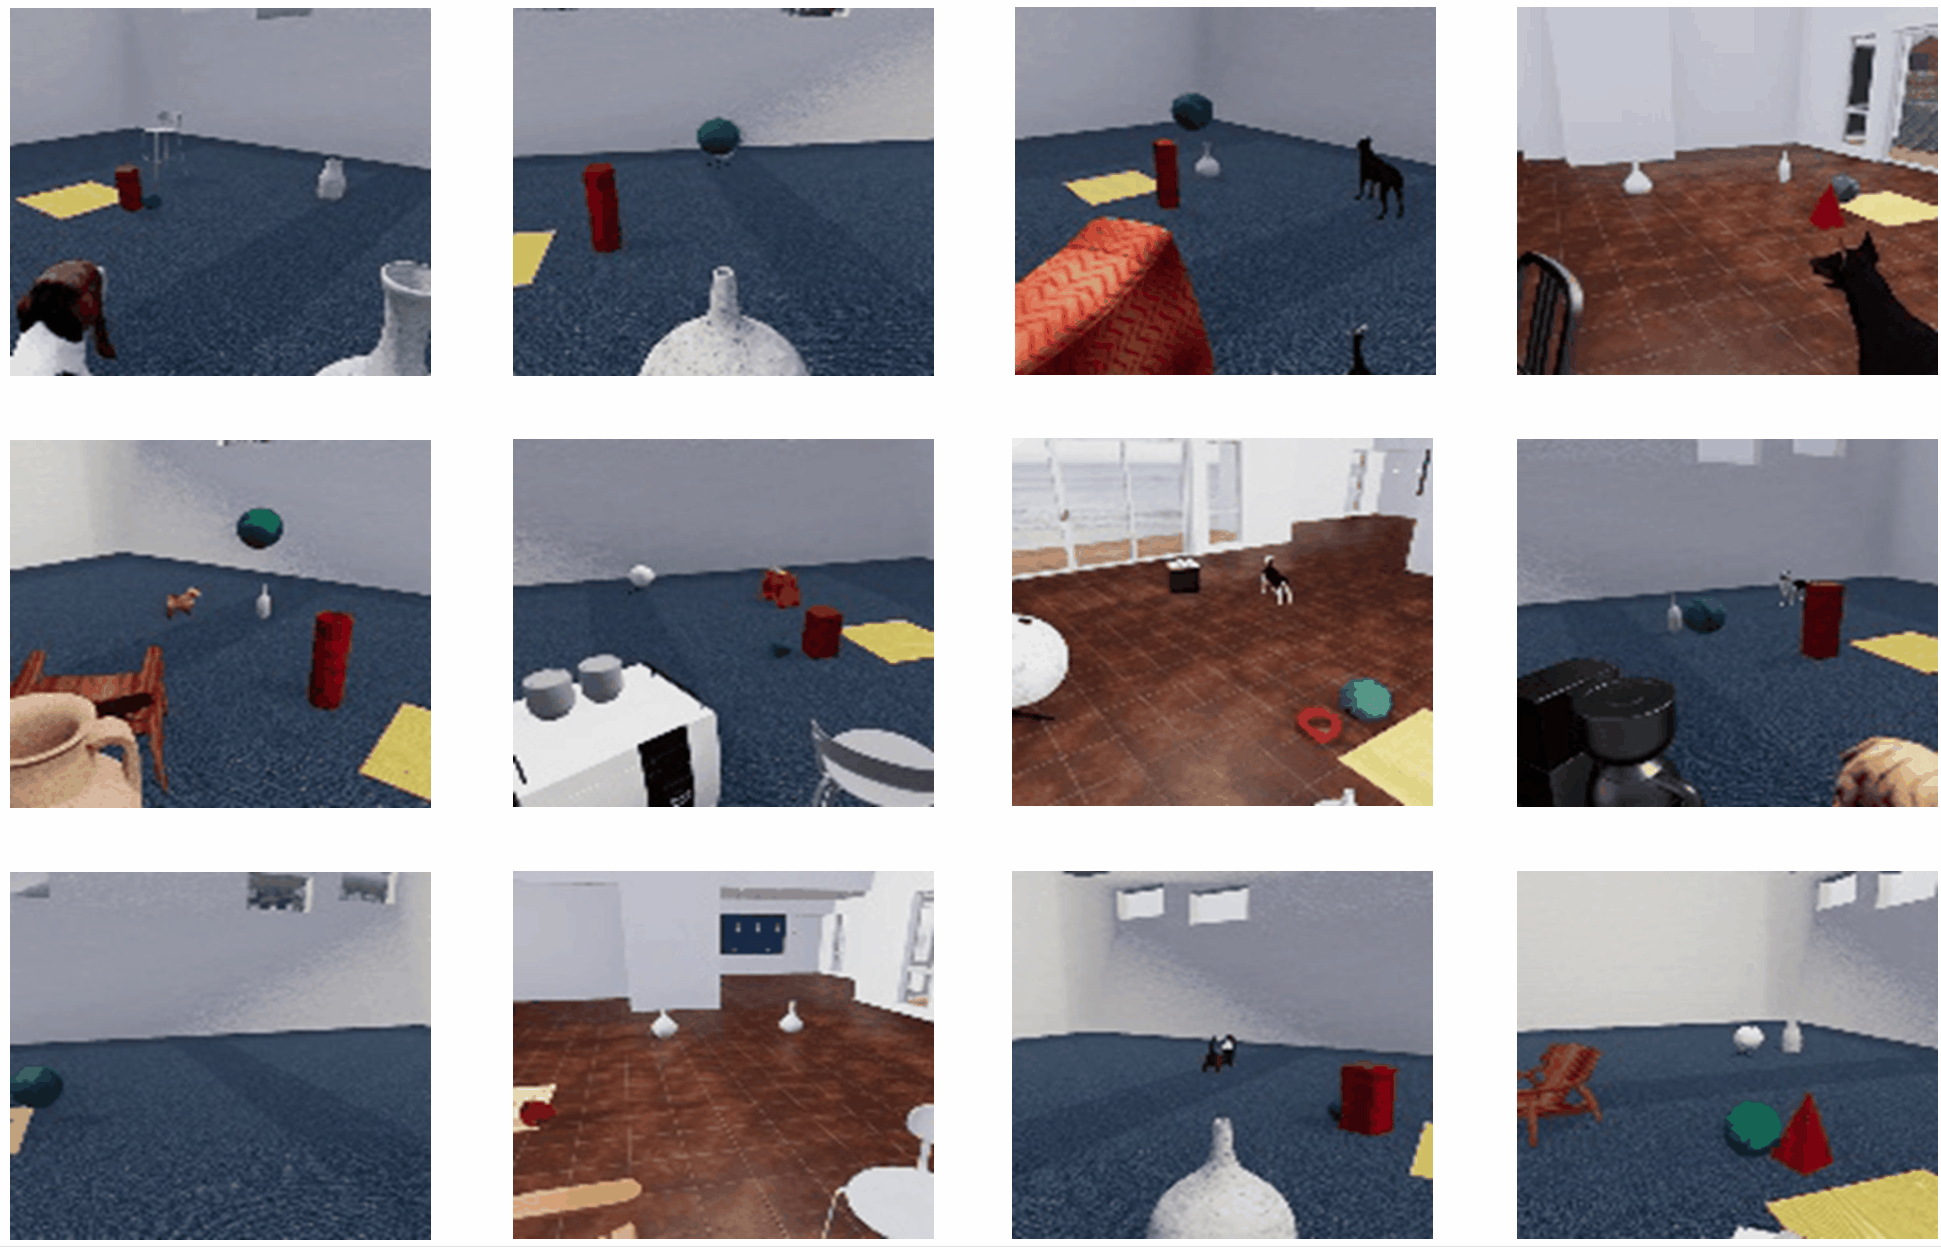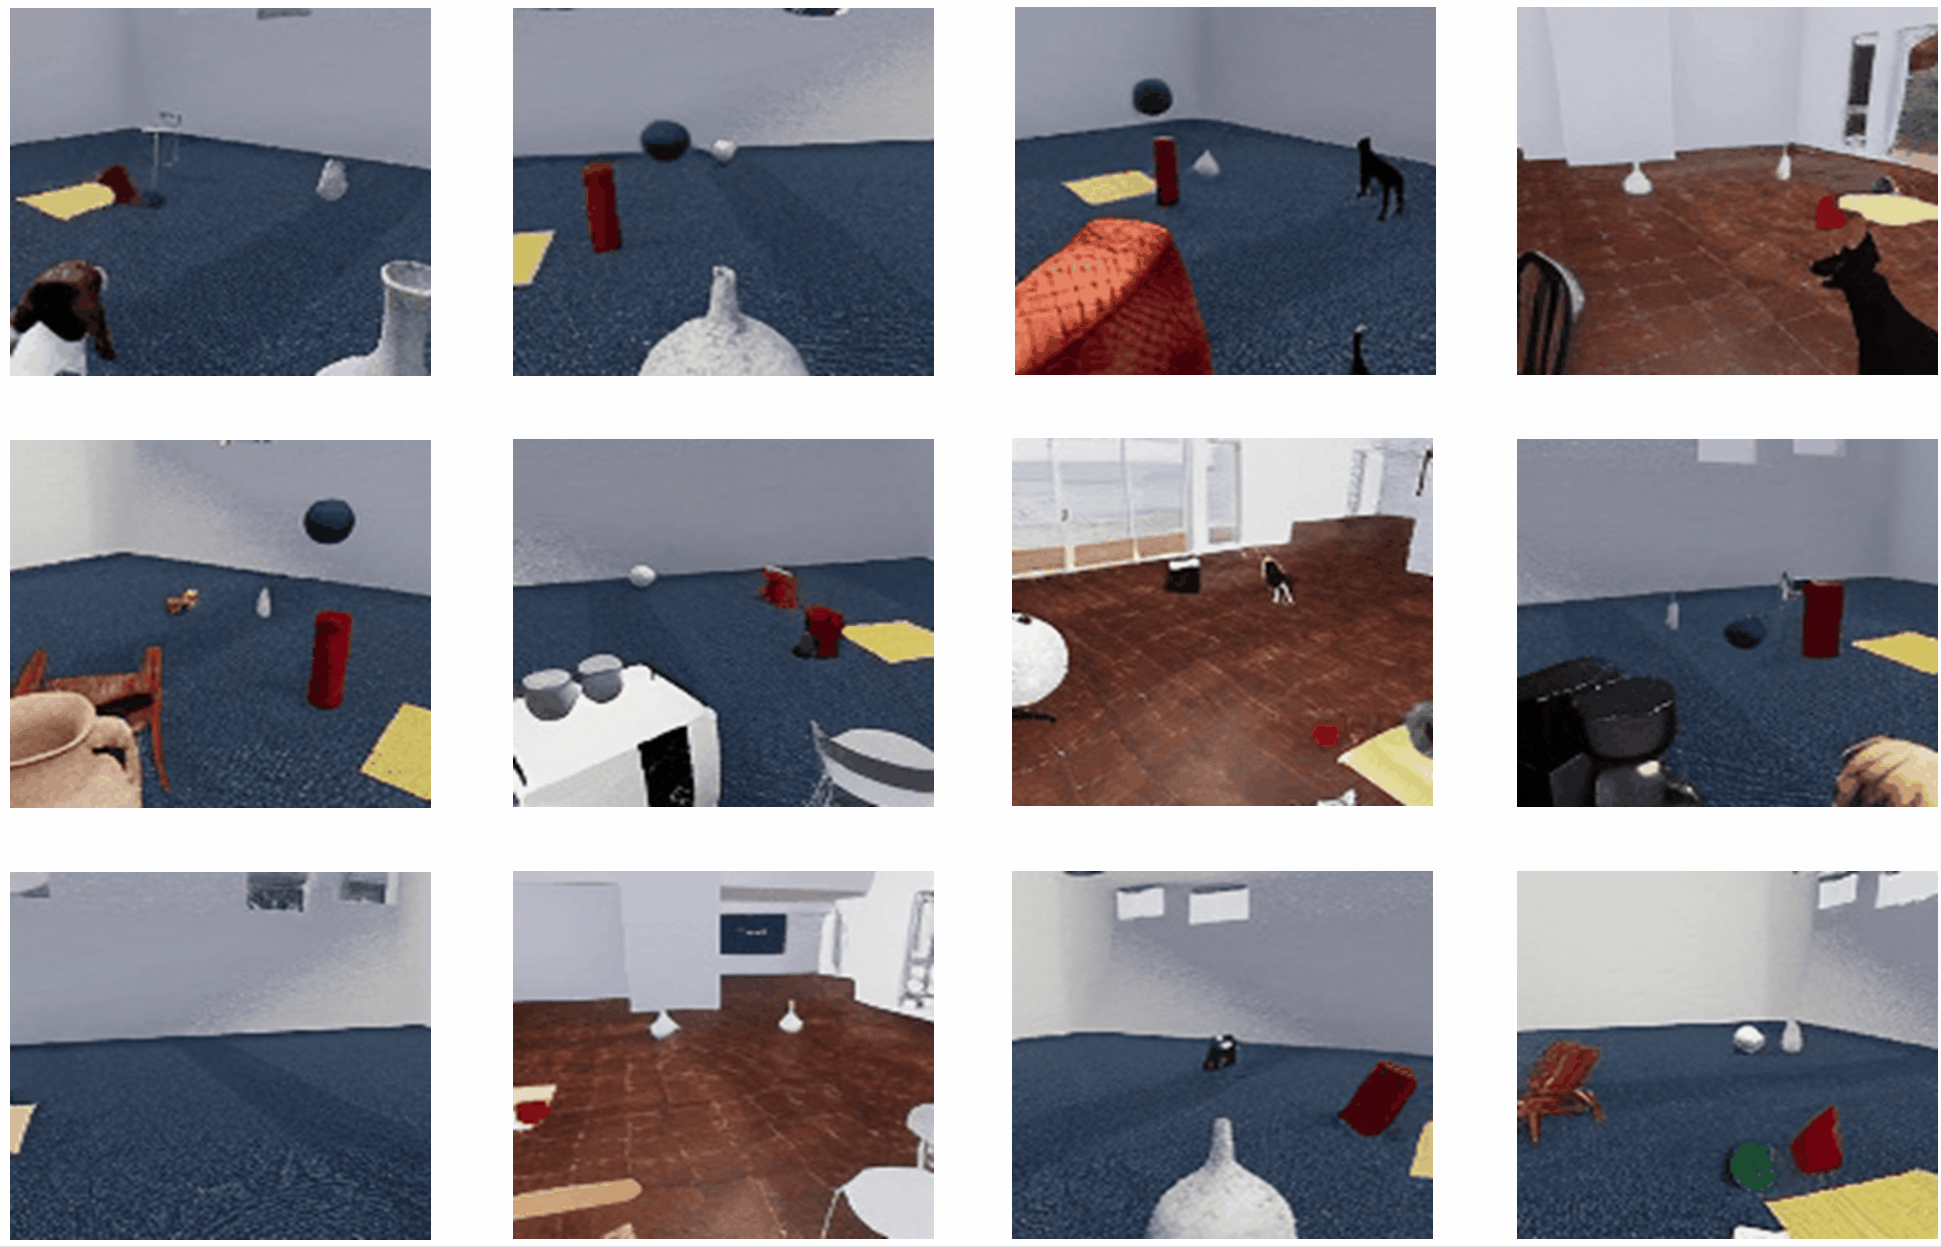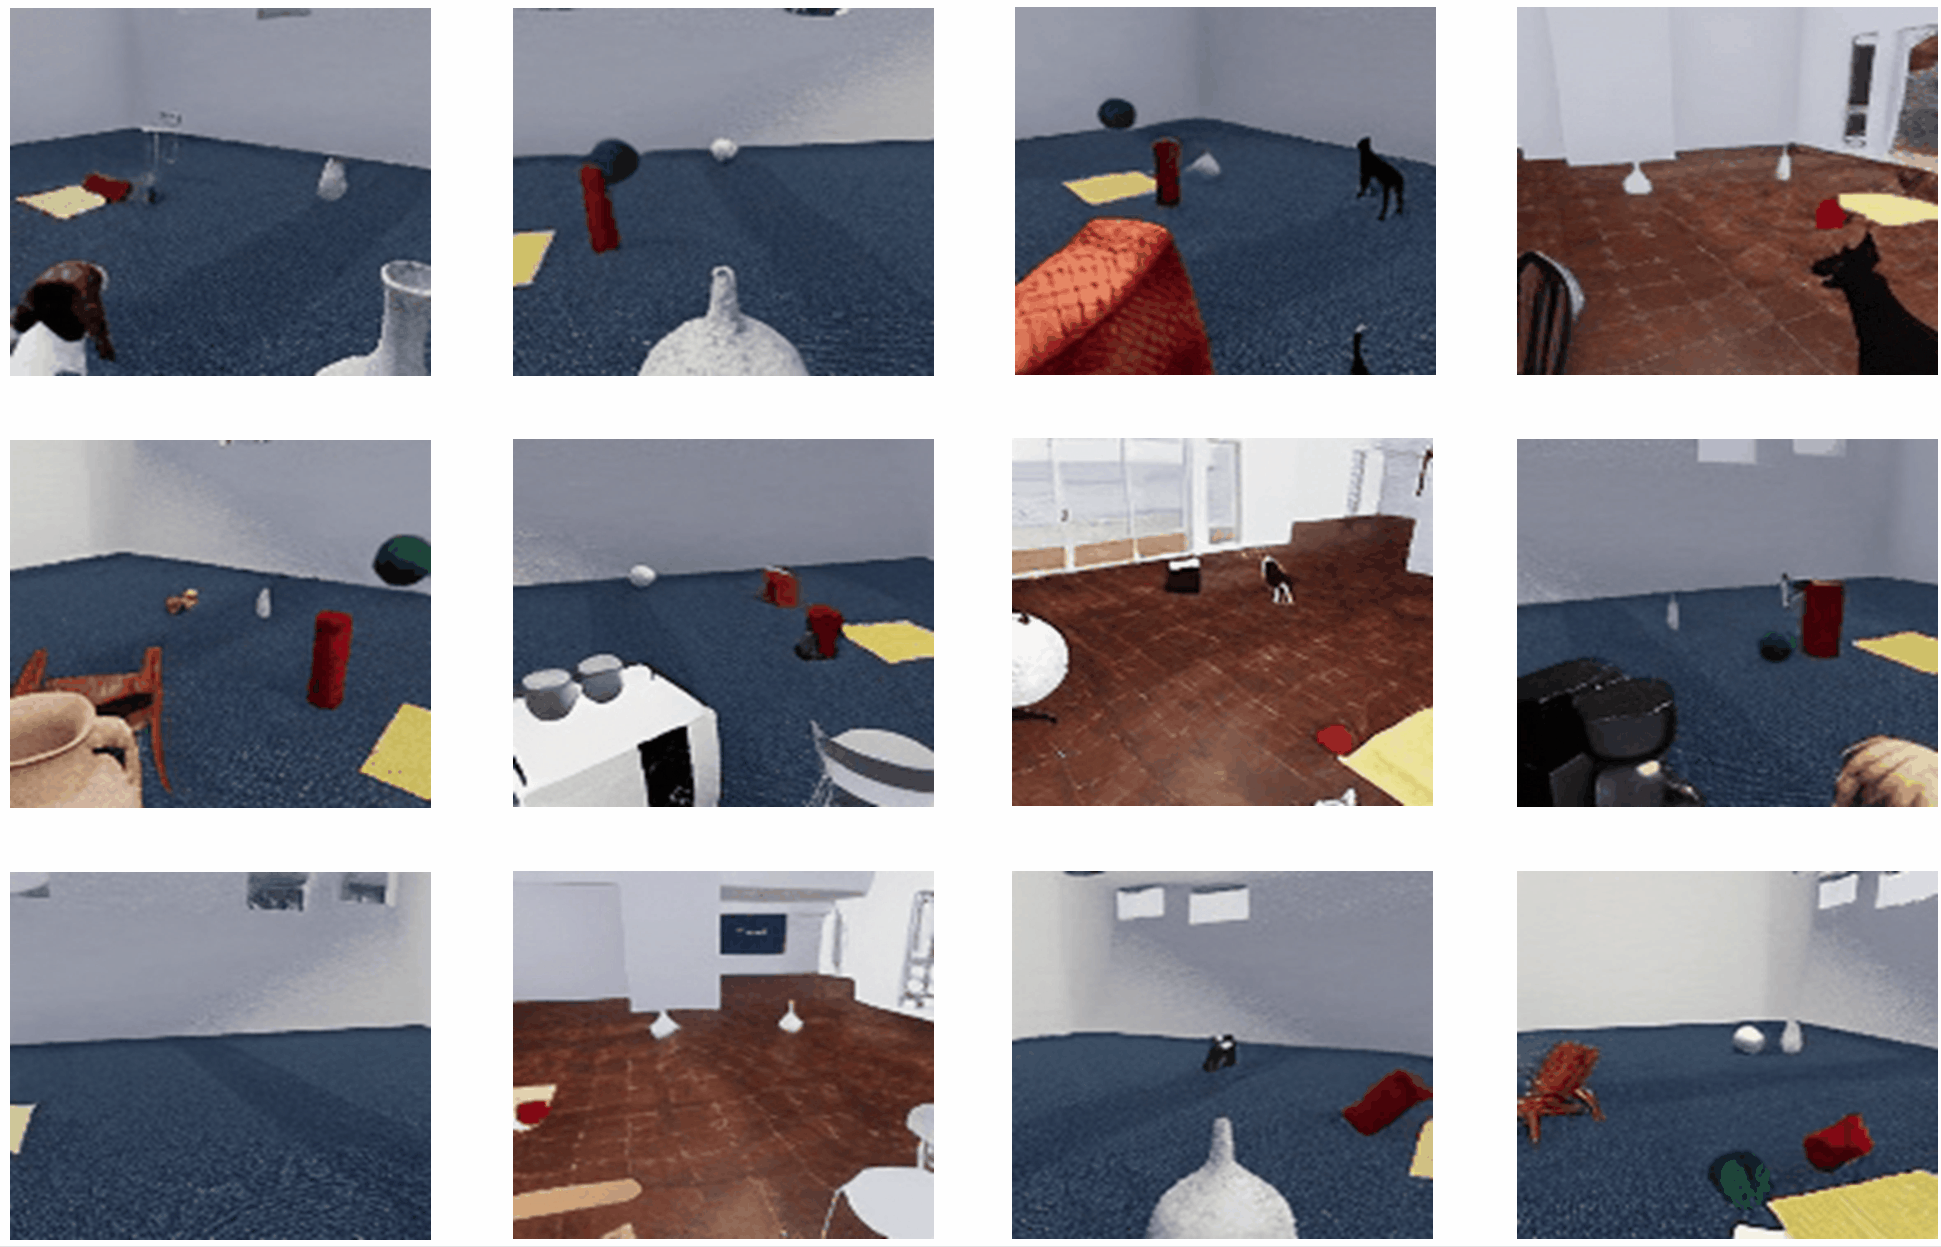
Sophon ইঞ্জিন দল ভিডিটি-এর সাধারণ ভৌত আইনের সিমুলেশন অন্বেষণের উপর দৃষ্টি নিবদ্ধ করে এবং ফিশন ডেটা সেটে প্রশিক্ষিত ভিডিটি। নিম্নলিখিত উদাহরণে, আমরা দেখতে পেলাম যে VDT সফলভাবে শারীরিক প্রক্রিয়াগুলিকে অনুকরণ করেছে, যেমন বলটি প্যারাবোলিক ট্র্যাজেক্টোরি বরাবর চলমান এবং বলটি একটি সমতলে ঘূর্ণায়মান এবং অন্যান্য বস্তুর সাথে সংঘর্ষ। একই সময়ে, লাইন 2-এর দ্বিতীয় উদাহরণ থেকে এটিও দেখা যায় যে VDT বলের গতি এবং ভরবেগ ধরেছে, কারণ বলটি শেষ পর্যন্ত অপর্যাপ্ত প্রভাব শক্তির কারণে স্তম্ভের নিচে ছিটকে যায়নি। এটি প্রমাণ করে যে ট্রান্সফরমার আর্কিটেকচার নির্দিষ্ট শারীরিক আইন শিখতে পারে।
তারা ফটো ভিডিও জেনারেশন টাস্কের উপর গভীরভাবে অনুসন্ধানও করেছে। এই কাজটির ভিডিও তৈরির মানের উপর খুব উচ্চ প্রয়োজনীয়তা রয়েছে, কারণ আমরা স্বাভাবিকভাবেই মুখ এবং অক্ষরের গতিশীল পরিবর্তনের জন্য বেশি সংবেদনশীল। এই কাজের বিশেষত্বের পরিপ্রেক্ষিতে, ফটো ভিডিও তৈরির চ্যালেঞ্জ মোকাবেলায় গবেষকদের ভিডিটি (বা সোরা) এবং নিয়ন্ত্রণযোগ্য প্রজন্মকে একত্রিত করতে হবে। বর্তমানে, Sophon ইঞ্জিন ফটো ভিডিও জেনারেশনের বেশিরভাগ মূল প্রযুক্তি ভেঙ্গে ফেলেছে এবং Sora থেকে ভালো ফটো ভিডিও জেনারেশন কোয়ালিটি অর্জন করেছে। Sophon ইঞ্জিন প্রতিকৃতিগুলির নিয়ন্ত্রণযোগ্য প্রজন্মের অ্যালগরিদমকে অপ্টিমাইজ করতে থাকবে, এবং সক্রিয়ভাবে বাণিজ্যিকীকরণও অন্বেষণ করছে৷ বর্তমানে, একটি নিশ্চিত বাণিজ্যিক অবতরণ দৃশ্যকল্প পাওয়া গেছে, এবং এটি নিকট ভবিষ্যতে বড় মডেল অবতরণের "শেষ মাইল" অসুবিধা ভঙ্গ করবে বলে আশা করা হচ্ছে।
ভবিষ্যতে, মাল্টি-মডেল বৃহৎ মডেল ডেটা সোর্সের সমস্যা সমাধানের জন্য আরও বহুমুখী VDT একটি শক্তিশালী হাতিয়ার হয়ে উঠবে। ভিডিও জেনারেশন ব্যবহার করে, ভিডিটি বাস্তব জগতের অনুকরণ করতে সক্ষম হবে, ভিজ্যুয়াল ডেটা উৎপাদনের দক্ষতা আরও উন্নত করবে এবং মাল্টি-মডেল বড় মডেল অ্যাওয়াকারের স্বাধীন আপডেটের জন্য সহায়তা প্রদান করবে।
উপসংহার
Awaker 1.0 হল Sophon ইঞ্জিন দলের জন্য "AGI উপলব্ধি করার" চূড়ান্ত লক্ষ্যের দিকে অগ্রসর হওয়ার জন্য একটি গুরুত্বপূর্ণ পদক্ষেপ। Sophon Engine APPSO কে বলেছে যে দলটি বিশ্বাস করে যে AI এর স্ব-অন্বেষণ, আত্ম-প্রতিফলন এবং অন্যান্য স্বায়ত্তশাসিত শেখার ক্ষমতাগুলি বুদ্ধিমত্তা স্তরের জন্য গুরুত্বপূর্ণ মূল্যায়নের মানদণ্ড এবং প্যারামিটার স্কেল (স্কেলিং আইন) ক্রমাগত বৃদ্ধির মতো সমান গুরুত্বপূর্ণ।
Awaker 1.0 "সক্রিয় ডেটা জেনারেশন, মডেল প্রতিফলন এবং মূল্যায়ন, এবং ক্রমাগত মডেল আপডেট" এর মতো মূল প্রযুক্তিগত কাঠামো বাস্তবায়ন করেছে, যা বোঝার দিক এবং জেনারেশন উভয় দিকেই অগ্রগতি অর্জন করবে বলে আশা করা হচ্ছে এটি মাল্টি-মডেল লার্জের বিকাশকে ত্বরান্বিত করবে মডেল শিল্প এবং শেষ পর্যন্ত মানুষের AGI উপলব্ধি করার অনুমতি দেয়।
# Aifaner এর অফিসিয়াল WeChat পাবলিক অ্যাকাউন্ট অনুসরণ করতে স্বাগতম: Aifaner (WeChat ID: ifanr) যত তাড়াতাড়ি সম্ভব আপনাকে আরও উত্তেজনাপূর্ণ সামগ্রী সরবরাহ করা হবে।